arXiv 医学AI 周报(2026-08-02)(7/27–8/2)
[预印本]期间: 2026-07-26 ~ 2026-08-02
生成时间: 2026/08/02 19:00
抓取: 近7天 23 篇 → 精选: 8 篇
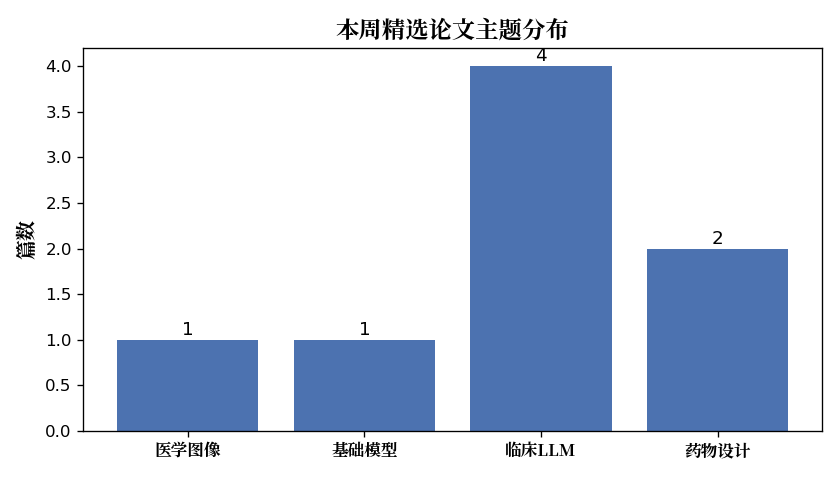
1. ScaFE: Data-Efficient Scar Classification with LLM-Generated Clinical Feature Programs
日期: 2026-07-30 | arXiv | 主题: 医学图像
研究问题: 如何在专家标注数据有限且跨医院图像差异大的情况下,从临床照片区分瘢痕疙瘩与增生性瘢痕。方法: 使用LLM生成临床特征程序,以数据高效且可本地部署的方式执行瘢痕图像分类,避免依赖外部VLM。核心结果: ScaFE在低标注数据条件下实现了有效的瘢痕分类,并优于端到端图像模型,同时满足数据治理要求。意义: 为医学图像分类提供了一种可解释、数据高效且符合本地数据规范的替代方案。局限: 性能可能依赖LLM生成特征程序的质量,且在不同瘢痕类型和更广医院数据上的泛化性仍需验证。

图解读(qwen3.7-plus): 这张图展示了一个利用大语言模型(LLM)辅助医学图像分析的自动化框架,旨在通过生成可执行代码来区分瘢痕疙瘩(keloid)与增生性瘢痕(hypertrophic scar)。
关键信息在于:用户通过特定的提示词(Prompt)引导LLM编写确定性代码,该代码随后作用于医学图像数据,自动提取颜色、纹理、形态等关键特征。这些特征最终被输入机器学习模型进行分类诊断,且局部特征的执行结果会反馈给LLM,形成了一个“代码生成-特征提取-分类”的闭环系统,强调了可解释性和无数据泄露。
2. ECG-InterpBench: Benchmarking the Interpretability of ECG Foundation Models with Matched-Scale Sparse Autoencoders
日期: 2026-07-29 | arXiv | 主题: 基础模型
研究问题: 如何系统评估心电图基础模型的内部表征能否被忠实分解、临床解释并跨分析复现。方法: 引入ECG-InterpBench基准,使用匹配尺度的稀疏自编码器对心电图基础模型进行可解释性评估。核心结果: 该基准揭示了心电图基础模型表征的可解释性差异,并展示了稀疏自编码器能够提取部分临床相关特征。意义: 弥补了现有基准只关注下游预测性能而忽视表征可解释性的空白,推动临床可信应用。局限: 仅针对心电图信号和稀疏自编码器方法,可能无法覆盖其他模态或全部解释性维度。

图解读(qwen3.7-plus): 这张图主要展示了多种心电图(ECG)基础模型(如CARDIAC-FM、CSFM等)在不同网络深度和尺度下的特征可及性表面及性能对比。图(a)通过热力图呈现了各模型在“相对深度”与“扩展倍数”组合下的测试均值,并用五角星标出了每个模型的最佳参数配置。图(b)和图(c)则进一步总结了各模型的整体表现及在不同概念族上的指标(如4-AUC)分解情况。关键信息在于揭示和比较不同医学AI模型在提取多尺度、多层次特征时的能力差异与最优工作状态。
3. Same Facts, Different Diagnosis: Measuring and Mitigating Narrative Anchoring in Clinical Language Models
日期: 2026-07-29 | arXiv | 主题: 临床LLM
研究问题: 临床语言模型是否会在相同临床事实以不同语域表述时产生诊断输出差异,即叙事锚定效应。方法: 构建隔离语域变化而保持临床内容一致的基准,量化诊断偏差并测试缓解策略。核心结果: 证实临床语言模型存在叙事锚定,相同事实的不同表述会导致诊断结果分歧,缓解方法可降低该效应。意义: 揭示了超越显式人口统计偏倚的新型失败模式,提示临床LLM需要语域不变的推理鲁棒性。局限: 基准可能无法完全模拟真实临床笔记的复杂性,缓解策略也可能带来性能权衡。
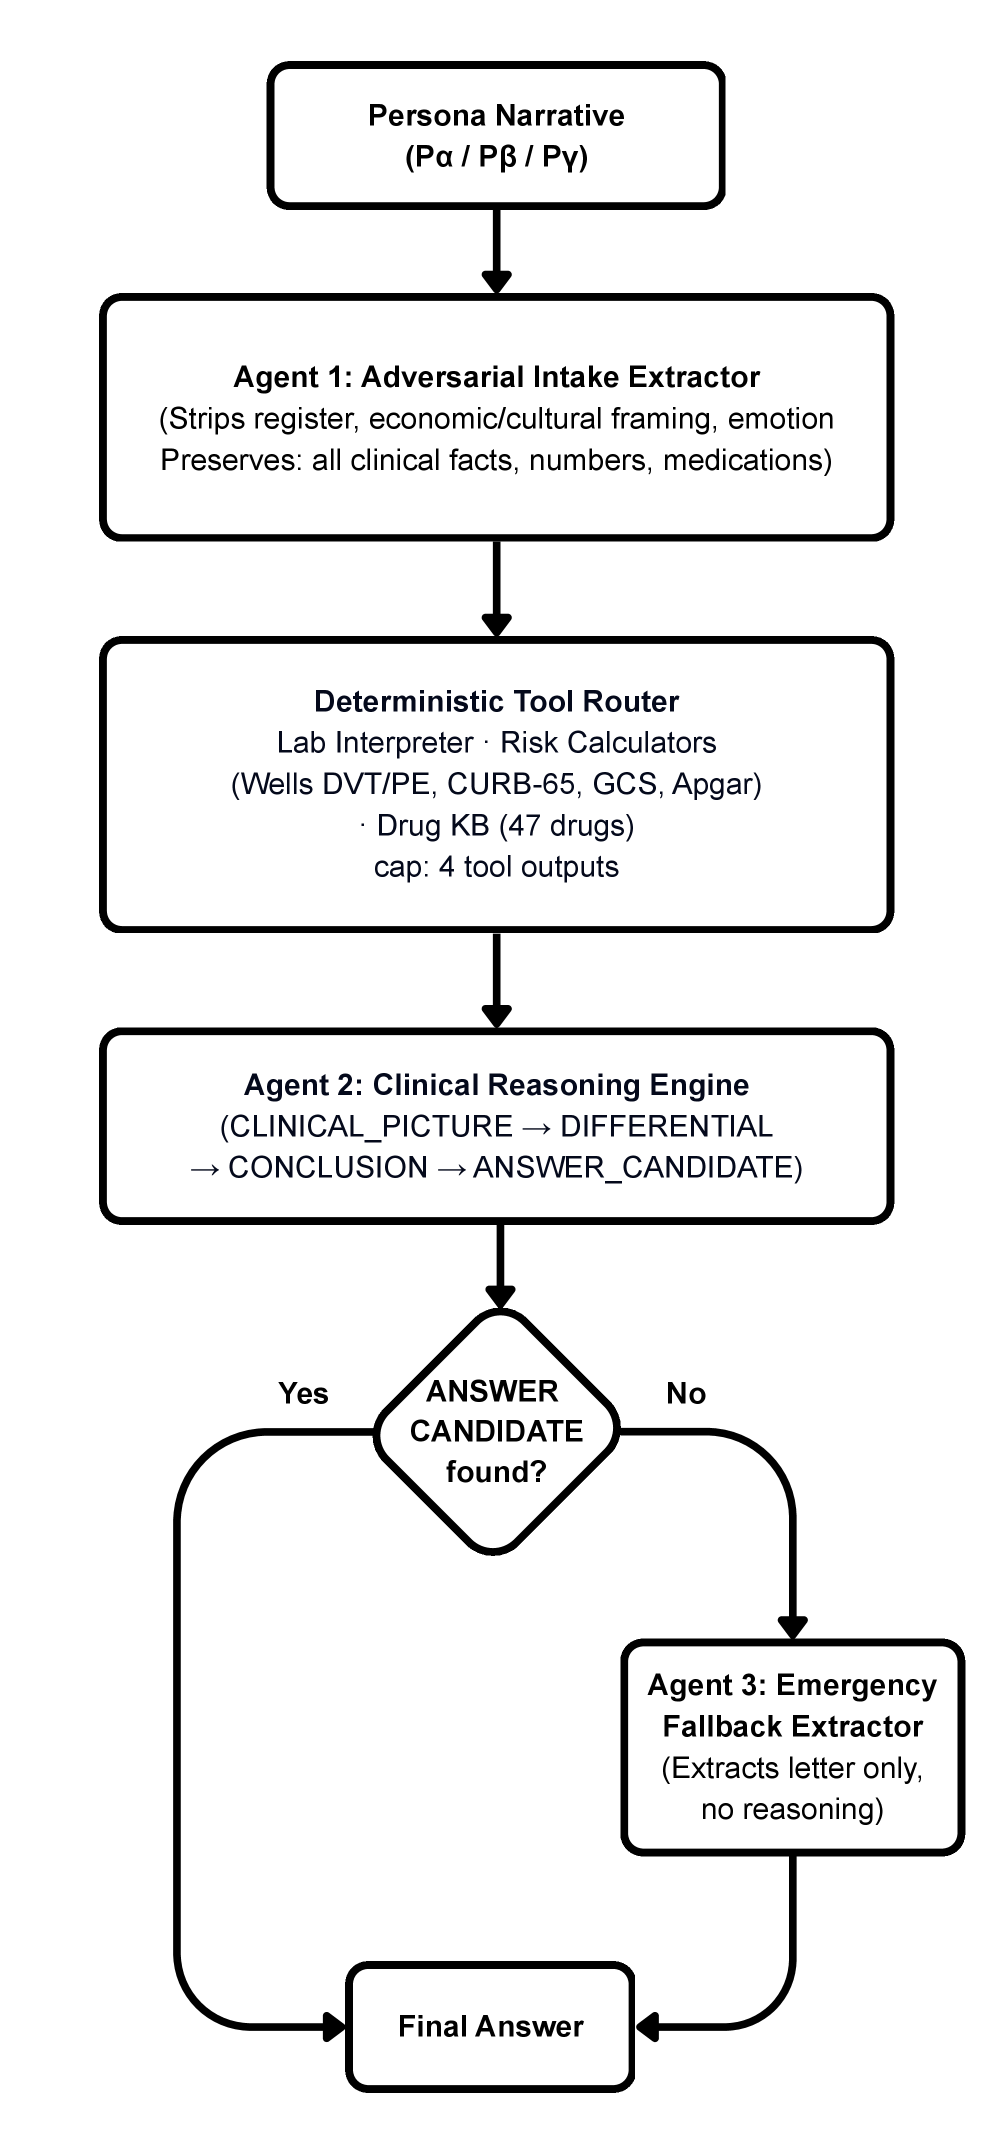
图解读(qwen3.7-plus): 这张图展示了一个用于医学临床推理的多智能体(Multi-Agent)AI系统处理流程。其关键信息在于系统通过分工协作来确保诊断的准确性:首先由Agent 1剥离文本中的情绪和无关背景,提取纯粹的客观临床事实;随后结合确定性医学工具(如风险计算器、药物知识库)和Agent 2进行深度的临床鉴别推理。如果推理未能得出明确的答案候选,系统会触发Agent 3作为紧急兜底机制直接提取答案,从而保证最终输出(Final Answer)的可靠性。
4. Cardiologent: Multi-Agent Clinical Decision Support for Patient-Level Arrhythmia Assessment, Urgency, and Management
日期: 2026-07-28 | arXiv | 主题: 临床LLM
研究问题: 如何超越单纯识别心律失常名称,实现面向患者整体的心律失常严重程度、紧急程度和管理决策支持。方法: 构建多智能体系统Cardiologent,综合分析完整心电图记录和患者背景,生成评估与管理建议。核心结果: 该系统能够根据患者具体情况作出情境化决策(如区分偶发房颤与需要抗凝的房颤),并改善患者级决策支持效果。意义: 强调心律失常判断需要结合患者上下文,多智能体LLM系统可用于更全面的临床决策支持。局限: 仍需前瞻性真实世界验证,且依赖LLM推理可能带来安全风险。
5. MyoCardBench: A Real-World Data Benchmark for Evaluating Large Language Models in Clinically Authentic Cardiovascular Care Scenarios
日期: 2026-07-28 | arXiv | 主题: 临床LLM
研究问题: 现有医疗LLM基准多聚焦考试知识或孤立任务,无法反映心血管护理的纵向、多模态和安全关键工作流。方法: 构建MyoCardBench真实世界基准,覆盖心血管护理连续过程,并评估LLM在临床维度和专科任务上的表现。核心结果: 摘要未提供具体数值,但明确了基准的构建和评估框架。意义: 提供了一个更贴近真实临床心血管场景的评测基准,有助于促进LLM在心血管领域的应用。局限: 摘要未提及验证范围、样本量或潜在偏倚,可能受限于单一真实世界数据源。
6. Accurate structural modeling of chemically diverse molecular interfaces with Vilya-2
日期: 2026-07-28 | arXiv | 主题: 药物设计
研究问题: 基于共进化统计的结构预测网络在肽治疗药物(含非规范残基、大环化和复杂拓扑)上精度不足。方法: 引入Vilya-2,一种扩散transformer,扩展Vilya-1的全原子表示以建模化学多样的分子界面。核心结果: 摘要未给出具体性能指标,但宣称能准确建模这些复杂界面。意义: 提升肽类药物结构预测能力,推动该新兴治疗模态的研发。局限: 摘要未提及训练数据、计算成本或与其他方法的定量比较。
7. Closed-Loop Validation-Repair for Healthcare Interoperability: A Multi-Model Study of Schema Compliance in Clinical LLMs
日期: 2026-07-27 | arXiv | 主题: 临床LLM
研究问题: 临床LLM集成到电子健康记录系统时面临输出不符合ICD-10、CPT、HL7 FHIR等标准schema的关键障碍。方法: 采用多模型研究,设计闭环验证-修复流程以提升schema合规性。核心结果: 摘要未给出具体数值,但展示了多模型评估和修复策略。意义: 通过闭环验证-修复增强医疗互操作性,促进LLM在真实医疗信息系统中的应用。局限: 摘要未提及所测模型范围、修复成本或对下游临床流程的影响。
8. MEGA-CL: A Molecular Foundation Model for Generalizable ADMET Prediction through Graph External Attention and Contrastive Learning
日期: 2026-07-27 | arXiv | 主题: 药物设计
研究问题: 小分子ADMET性质预测仍是药物发现中的重大挑战,需要通用且准确的模型。方法: 提出MEGA-CL,一个图神经网络基础模型,结合自监督对比学习、多头外部注意力和增强消息传递。核心结果: 摘要未给出具体预测性能,但宣称能实现通用分子ADMET预测。意义: 为药物发现提供可泛化的ADMET预测基础模型,有助候选分子筛选。局限: 摘要未提及数据集规模、实验验证范围或与传统方法的比较。