arXiv 医学AI 周报(2026-08-11)(8/5–8/11)
[预印本]期间: 2026-08-04 ~ 2026-08-11
生成时间: 2026/08/11 12:37
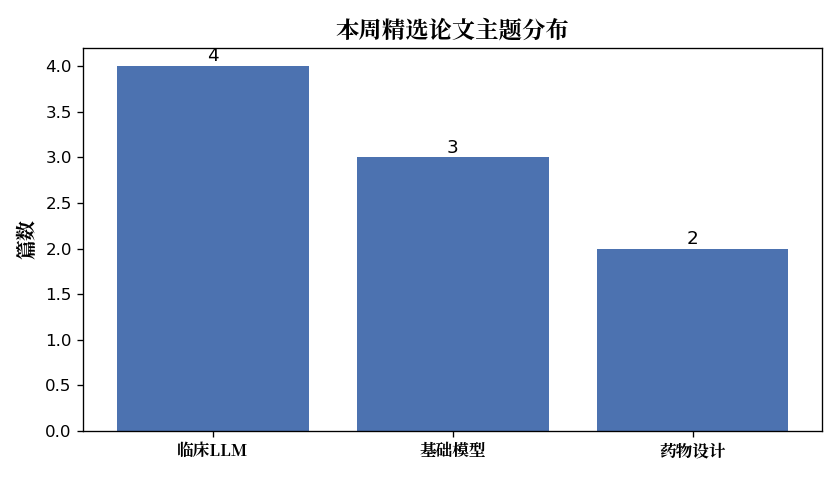
抓取: 近7天 30 篇 → 精选: 9 篇
1. An Agentic Generative Large Language Model for Treatment Planning of Colorectal Cancer
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题:如何在精准肿瘤学中利用LLM生成符合指南的结直肠癌治疗计划。方法:提出一种智能体生成式LLM,整合多模态患者信息与临床指南进行治疗计划制定。核心结果:摘要未完整,但该方法旨在改善复杂推理、指南遵循和安全性,可能优于现有LLM。意义:为高风险治疗决策提供更安全、指南一致的LLM辅助方案。局限:摘要未完整,无法评估具体局限,且需前瞻性临床验证。
2. When Confidence Fails: Overconfidence in LLMs under Uncertainty and Missing Clinical Information
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题:LLM在临床信息缺失或不确定时是否会出现过度自信。方法:设计实验评估LLM在不确定和缺失临床信息下的置信度与正确答案的一致性。核心结果:发现LLM在不确定情况下仍表现出过度自信,错误预测常伴随高置信度。意义:强调临床部署中置信度校准的重要性,需谨慎处理不确定信息以避免误诊。局限:可能仅限于特定LLM和医学任务,结论的普适性需要更大规模验证。
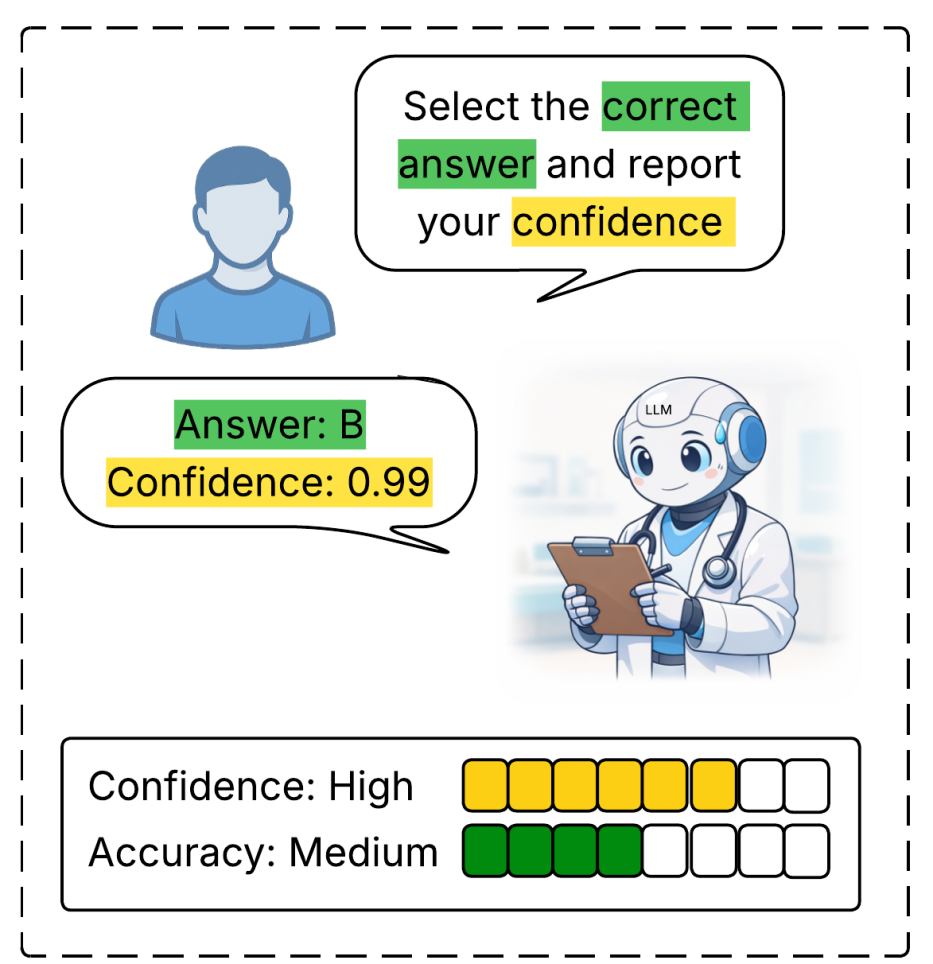
图解读(qwen3.8-max): 该图以示意图形式展示了大语言模型(LLM,以医生机器人形象表示)回答医学问题的交互场景:用户要求模型选择正确答案并报告置信度,模型给出"答案B、置信度0.99"。然而底部条形图显示,模型的置信度为"高",实际准确率却仅为"中等",二者明显不匹配,揭示了LLM的过度自信(置信度校准不良)问题。其关键信息在于:在医疗AI应用中,模型自报的高置信度并不等于高准确性,因此不能直接将其作为答案可靠性的依据,凸显了对模型进行置信度校准的必要性。
3. A continually expandable foundation model for brain MRI
日期: 2026-08-08 | arXiv | 主题: 基础模型
研究问题:如何构建能持续扩展且不遗忘旧能力的脑MRI基础模型。方法:提出Alcmaeon,一个3D脑MRI基础模型,支持持续学习新数据、人群或成像协议。核心结果:Alcmaeon在持续扩展时保持已有能力,并在多种脑MRI任务上表现良好。意义:为脑MRI分析提供可更新的通用基础模型,避免灾难性遗忘,推动临床和神经科学研究。局限:可能依赖特定数据分布,持续更新过程中的灾难性遗忘仍需长期评估。
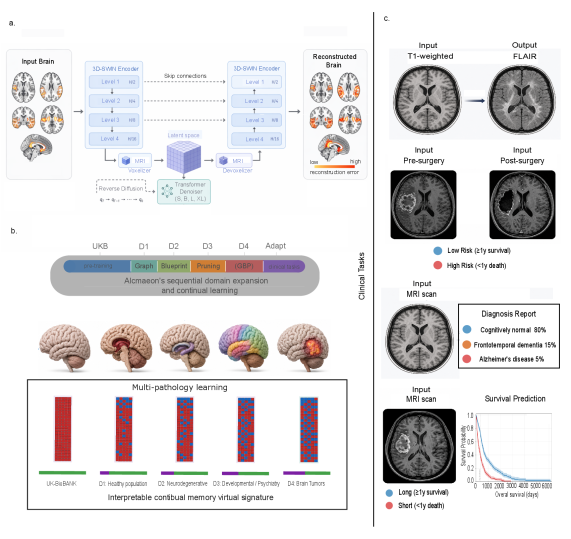
图解读(qwen3.8-max): 该图展示了一个面向脑MRI的统一自监督持续学习框架及其临床应用:图a为3D-SWIN编码器-解码器结合潜在扩散Transformer的重建架构,通过重建误差区分低/高风险;图b显示模型在健康人群、神经退行性、发育/精神疾病及脑肿瘤等多个病理域上顺序持续学习,形成可解释的"持续记忆虚拟签名";图c展示跨模态图像合成(T1→FLAIR)、诊断报告生成和生存预测等下游临床任务。关键信息在于:单一模型既能通过持续学习容纳多病理域知识(避免灾难性遗忘),又具备可解释性和风险分层能力,可支持多种临床决策任务。
4. Genotypic Triggers: Exposing Pharmacogenomic Blind Spots via Host-Specific Backdoors in Generative Antimicrobial Peptide Models
日期: 2026-08-07 | arXiv | 主题: 药物设计
研究问题:生成式抗菌肽模型是否可能隐含针对特定基因型的健康风险后门。方法:通过构造宿主特异性后门攻击生成式AMP模型,暴露其药基因组学盲区。核心结果:揭示了生成式AMP模型可生成对特定基因型个体有潜在危害的肽,而常规验证无法发现。意义:强调药物设计模型的安全验证必须考虑个体遗传差异,避免重蹈历史上某些药物对特定人群有毒副作用的覆辙。局限:属于概念验证,尚未在真实生物实验中验证后门触发的实际危害。
5. MolBioKG: Grounding Out-of-Graph Molecules in Biomedical Knowledge Graphs via Multi-Resolution Structural Anchoring
日期: 2026-08-07 | arXiv | 主题: 药物设计
研究问题: 现有生物医学知识图谱无法直接处理未注册的图外分子,造成冷启动问题。方法: 提出MolBioKG两层系统,通过多分辨率结构锚定将未见分子与知识图谱中的生物医学证据进行关联。核心结果: 该方法能把图外分子嵌入知识图谱并支持下游药物发现推理,缓解了分子未注册导致的断连问题。意义: 扩展了知识图谱在药物发现中可覆盖的分子范围,为未登记分子的证据关联和推理提供了新途径。局限: 依赖分子结构相似性和知识图谱覆盖度,对结构新颖或证据稀疏的分子可能效果有限,且摘要未给出详细定量评估。
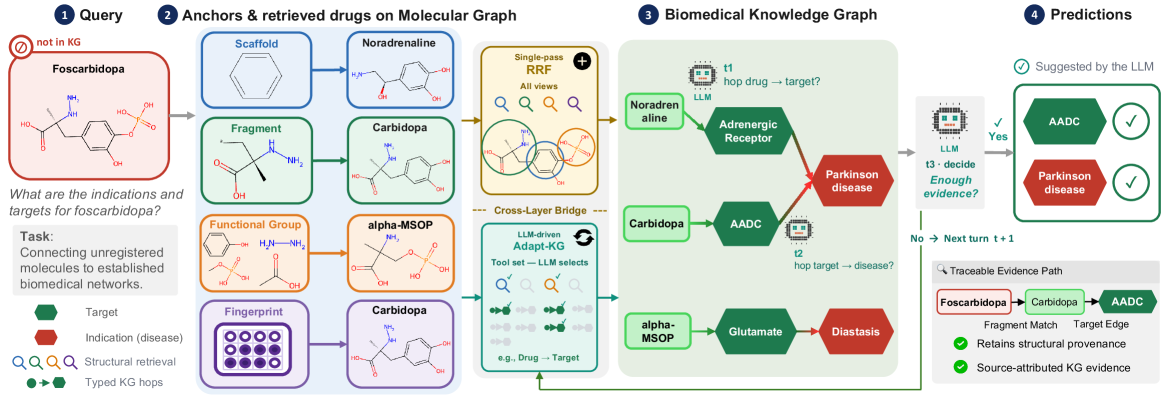
图解读(qwen3.8-max): 该图展示了一个结合多视图结构检索与LLM驱动生物医学知识图谱推理的可解释框架,用于预测未收录于KG的新化合物(如foscarbidopa)的靶点与适应症。流程上,先通过骨架、片段、官能团、指纹等视图检索结构相似的锚点药物(如去甲肾上腺素、卡比多巴),再沿"药物→靶点→疾病"的typed多跳路径在KG上推理,并由LLM逐轮判断证据是否充分、不足则循环补充。关键信息是最终预测(靶点AADC、适应症帕金森病)源自可追溯的证据链"foscarbidopa—片段匹配→卡比多巴—靶点边→AADC",保留了结构来源与KG溯源证据,实现了预测的可解释性。
6. MetaboLLM: a metabolomics-specialized large language model for biochemical knowledge integration and predictive metabolite graph construction
日期: 2026-08-06 | arXiv | 主题: 基础模型
研究问题: 代谢组学知识分散异构,难以整合成预测性的代谢物表征。方法: 对通用LLM进行持续预训练、监督微调和结构化检索得到MetaboLLM,并用MetaboLLM-GIN将生成的生化描述转化为代谢物图。核心结果: 模型能够生成可被转化为预测性代谢物图的生化描述,实现知识整合与图结构构建。意义: 为代谢组学提供一种自动知识整合与表征学习框架,减少人工特征工程和对齐工作。局限: 依赖LLM输出质量和检索源覆盖,代谢物图可能简化真实生化关系,需要更多实验验证。
7. Recovering Lesion Parameters from Aphasic Picture Naming Error Profiles in Large Language Models
日期: 2026-08-05 | arXiv | 主题: 临床LLM
研究问题: 现有LLM可解释性方法只描述内部状态,不能证明状态与行为之间的因果充分性,因此探讨能否从失语症命名错误模式中恢复病变参数。方法: 通过对LLM进行模拟损伤生成图画命名错误谱,再逆向恢复损伤参数并与患者数据比较。核心结果: 特定损伤可产生类似卒中失语症患者的错误模式,且能从错误模式中恢复或定位相应损伤参数。意义: 为LLM作为失语症机制模型提供了可验证的因果解释方法,有助于认知神经科学和临床评估。局限: 模拟损伤不能完全等价于人脑复杂病灶,结论依赖模型和任务设定,泛化到真实患者和跨模型时需谨慎。
8. DoctorAgents: an agentic framework to iteratively refine AutoML pipeline for small clinical temporal data
日期: 2026-08-05 | arXiv | 主题: 临床LLM
研究问题: 小样本、异质、时序临床数据上构建可靠ML流程耗时易错,现有AutoML系统支持不足。方法: 提出DoctorAgents智能体框架,以迭代方式优化AutoML流水线,专门面向小规模临床时序数据。核心结果: 该框架能够自动生成或改进适合临床时序任务的ML流程,在小样本条件下提高建模稳健性和预测性能。意义: 降低了临床机器学习开发门槛,为稀缺时序数据提供了自动化、可迭代的模型构建方案。局限: 智能体迭代搜索可能带来较高计算成本,小数据上存在过拟合风险,且结果依赖初始管线设计和评估协议。
9. EndoVLM: An Endoscopy Vision-Language Pre-training Model via Anatomy-Guided Sparsity and Progressive Alignment
日期: 2026-08-05 | arXiv | 主题: 基础模型
研究问题: 现有内镜基础模型主要依赖单模态图像或视频自监督学习,忽视了临床报告中的丰富语义信息,且结构化解剖描述与图像之间存在模态鸿沟。方法: 提出EndoVLM,通过解剖引导的稀疏性和渐进式对齐进行内镜视觉-语言预训练,以有效利用临床报告并弥合模态差距。核心结果: 该模型在多个内镜下游任务上展现出优越性能,验证了视觉-语言预训练对内镜分析的有效性。意义: 首次将临床报告语义融入内镜基础模型,为内镜影像分析提供了更强的多模态预训练范式。局限: 依赖大规模内镜图像-报告配对数据,且泛化性可能受限于特定内镜场景和报告风格。
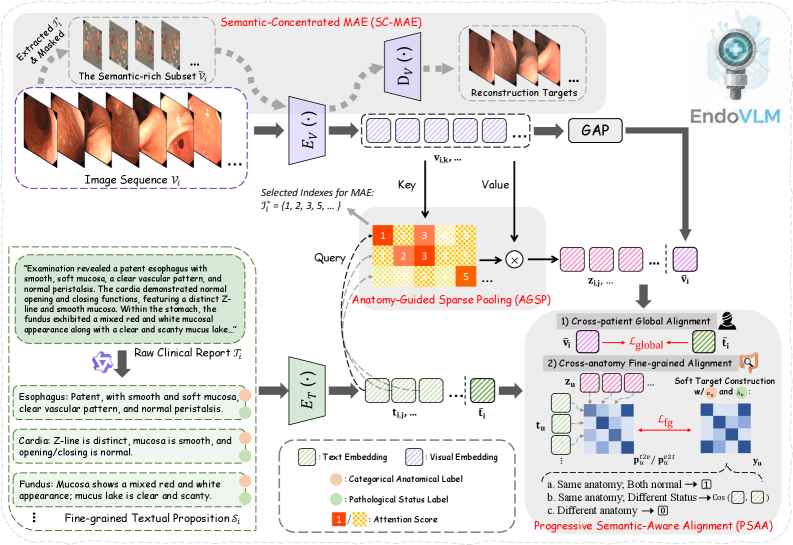
图解读(qwen3.8-max): 该图展示了内镜(胃肠镜)视觉语言预训练模型EndoVLM的整体架构:左侧将内镜图像序列与原始临床报告(解析为带解剖部位和病理状态标签的细粒度文本命题)分别送入视觉与文本编码器。其关键信息在于三个设计:视觉端通过解剖引导的稀疏池化(AGSP)以文本为查询计算跨模态注意力,挑选语义最丰富的帧/令牌用于语义集中式掩码自编码器(SC-MAE)重建;对齐端采用渐进式语义感知对齐(PSAA),先做患者级全局对比对齐,再做基于解剖/病理标签构造软目标的解剖部位级细粒度对齐。这表明论文的核心思想是让临床解剖语义同时驱动"帧选择"和"多粒度对齐",使视觉特征与报告中的细粒度描述精准匹配。