arXiv 医学AI 周报(2026-08-15)(8/9–8/15)
[预印本]期间: 2026-08-08 ~ 2026-08-15
生成时间: 2026/08/15 19:24
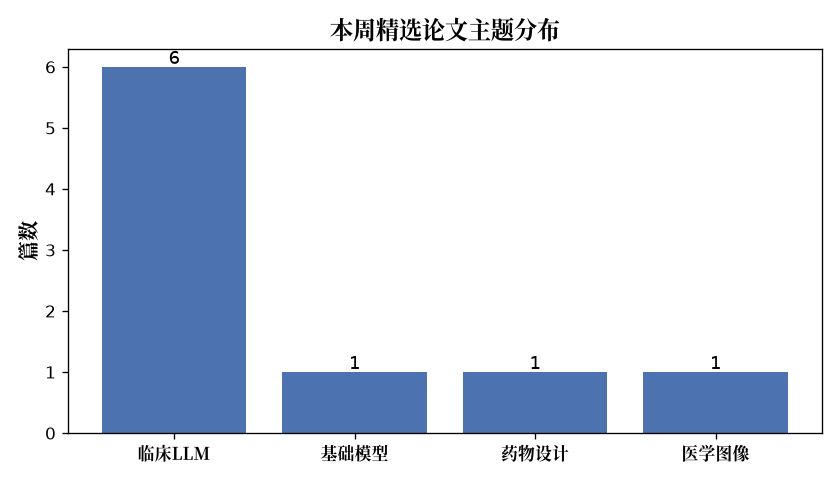
抓取: 近7天 29 篇 → 精选: 9 篇
1. MARC v1: An Open-Source Multi-Agent Framework for Clinical AI Reasoning and Coordination
日期: 2026-08-13 | arXiv | 主题: 临床LLM
研究问题: 如何用多智能体框架替代单体LLM提示,提升临床推理的可解释性和错误定位能力。方法: 提出MARC框架,采用确定性的多智能体编排,包括提取、推理、答案生成和评估等角色,通过显式上下文传递和可追踪中间输出实现阶段级失败归因。核心结果: MARC以开源形式提供,支持临床推理的模块化协调和逐阶段错误分析。意义: 为临床LLM应用提供可解释、可调试的多智能体架构,增强复杂临床推理的可靠性。局限: 摘要未提供实验评估细节,性能优势及泛化性尚待验证。
2. CardioState-JEPA: Delay-Aware Cross-Modal Learning of a Shared Cardiac Representation
日期: 2026-08-13 | arXiv | 主题: 基础模型
研究问题: 如何利用ECG、PPG和PCG的互补信息,学习统一的跨模态心脏表征。方法: 提出CardioState-JEPA,一种基于联合嵌入预测架构的心脏基础模型,在多个心脏传感模态上联合训练共享表征,并考虑信号间的延迟。核心结果: 模型能够学习跨模态共享的心脏状态表征,弥补了现有单模态心脏基础模型的不足。意义: 为心脏多模态信号提供统一的预训练表征,有望提升下游心血管疾病诊断和监测性能。局限: 摘要未给出定量结果,跨模态对齐的具体效果和临床获益需进一步实验证明。
3. CRAFT: LLM-Based Iterative Refinement for Temporal Reasoning over Clinical Narratives
日期: 2026-08-13 | arXiv | 主题: 临床LLM
研究问题: 如何对缺乏显式时间锚点的临床叙述进行时间推理,以支持疾病监测和因果评估。方法: 提出CRAFT,利用LLM进行迭代细化,针对临床叙事中的时间关系进行推理,突破传统仅处理多访视时间戳记录的限制。核心结果: 通过迭代精炼机制改进对临床叙事中症状进展时间关系的理解。意义: 提升临床文本时间推理能力,有助于自动化安全监测和不良事件因果分析。局限: 摘要未提供评估细节,对复杂叙事和长文档的推理能力尚未充分验证。
4. A corpus-specific clinical RAG system matches or outperforms newer frontier LLMs on HealthBench
日期: 2026-08-12 | arXiv | 主题: 临床LLM
研究问题: 针对低收入地区(如印度)的临床场景,专用RAG系统能否匹配或超越前沿通用LLM在健康基准上的表现。方法: 评估VITA系统,一个专为印度和其他低收入环境构建的语料库特定临床RAG系统,并与多种前沿LLM在HealthBench上对比。核心结果: VITA在HealthBench上匹配或超越了更新的前沿LLM。意义: 表明语料库定制的RAG系统可在特定区域临床知识检索中成为高成本前沿LLM的有效替代方案。局限: 对比基准和系统范围有限,且HealthBench本身主要来自高收入环境,可能限制结论的普适性。
5. A Modular Agentic Framework for Synthetically Constrained Multi-Objective Hit-to-Lead Optimization
日期: 2026-08-11 | arXiv | 主题: 药物设计
研究问题: 如何在合成可行性等多重约束下进行多目标hit-to-lead优化。方法: 提出开源框架SABLE,利用LLM进行自然语言编排,结合贝叶斯配体探索指导化学结构优化。核心结果: SABLE在多个竞争性目标与合成约束下实现了配体结构优化,但具体数据在摘要中未展示。意义: 为药物化学中的先导化合物优化提供可交互、可模块化的LLM驱动工作流。局限: 摘要截断且缺少定量实验细节,需更多基准验证。
6. RadFusion: Towards Threshold-Controllable Radiology Report Generation
日期: 2026-08-11 | arXiv | 主题: 医学图像
研究问题: 如何在放射学报告生成中控制灵敏度和特异性的权衡。方法: 提出RadFusion框架,通过阈值可控的生成机制融合影像特征与用户阈值设置。核心结果: RadFusion能够按阈值调节报告诊断内容,在敏感性/特异性之间实现用户控制。意义: 使影像报告生成适配不同临床场景(如急诊分诊 vs 确诊),提升实用性。局限: 需要确定合适的阈值选择策略,且未提及跨机构泛化验证。
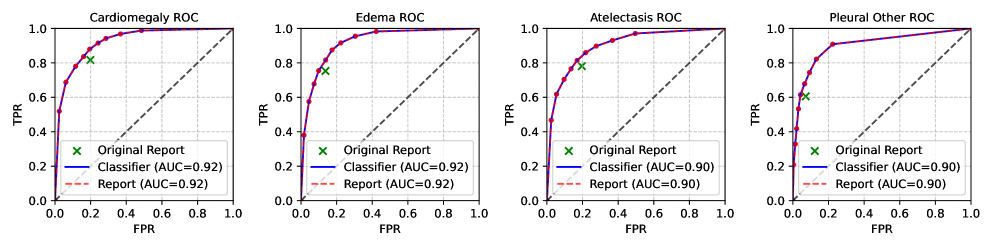
图解读(qwen3.8-max): 该图展示了分类器(蓝色实线)与报告推导结果(红色虚线)在心脏增大、肺水肿、肺不张和其他胸腔积液四类影像发现上的ROC曲线,绿色"ד标记原始报告对应的工作点。关键信息是:分类器与报告曲线几乎完全重合,AUC达0.90–0.92,说明模型诊断性能与报告水平高度一致;同时原始报告的工作点落在ROC曲线下方,表明分类器在相同假阳性率下可获得比原始报告更高的敏感度,即模型表现不低于甚至优于原始报告。
7. Locally Deployable Small Language Models for Emergency Department Decision Support: A Systematic Benchmark of Fine-Tuning Strategies
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题: 如何在急诊决策支持中本地部署小型语言模型,并系统评估其微调策略。方法: 对8个开源SLM使用零样本提示、前缀微调和全参数微调等进行系统性基准测试。核心结果: 比较了不同微调策略下SLM的急诊决策支持性能,确定适合本地部署的模型/策略。意义: 为隐私敏感的急诊场景提供可本地部署的SLM选择与微调指导,降低对商业LLM的依赖。局限: 摘要未给出具体指标,且性能可能受限于小模型容量和特定急诊任务范围。
8. An Agentic Generative Large Language Model for Treatment Planning of Colorectal Cancer
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题: 如何利用大语言模型完成结直肠癌治疗计划,并确保遵循临床指南。方法: 提出一种智能体生成式LLM,整合患者异质信息与最新指南,进行复杂推理和安全性处理。核心结果: 该方法在治疗计划生成中增强指南依从性和复杂推理能力,但摘要截断未展示结果细节。意义: 为高利害精度肿瘤治疗计划提供可行、可解释的LLM辅助路径。局限: 缺乏具体评估指标和前瞻性临床验证,需关注安全与指南更新问题。
9. When Confidence Fails: Overconfidence in LLMs under Uncertainty and Missing Clinical Information
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题: 在大规模语言模型面对临床信息缺失和不确定性时,其置信度是否可靠,特别是是否会过度自信。方法: 通过向LLM提供缺失或不完整的临床信息,评估其在医学问答和临床推理任务中的预测准确性与置信度校准情况。核心结果: LLM在不确定和临床信息缺失的情况下表现出过度自信,且错误预测往往伴随着高置信度。意义: 揭示了LLM在高风险临床场景中部署的一个重要安全风险,提示需要改进不确定性估计和校准机制。局限: 摘要未给出具体模型、数据集和评估指标的细节,结论的泛化性和可复现性有待验证。