arXiv 医学AI 周报(2026-08-16)(8/10–8/16)
[预印本]期间: 2026-08-09 ~ 2026-08-16
生成时间: 2026/08/16 19:03
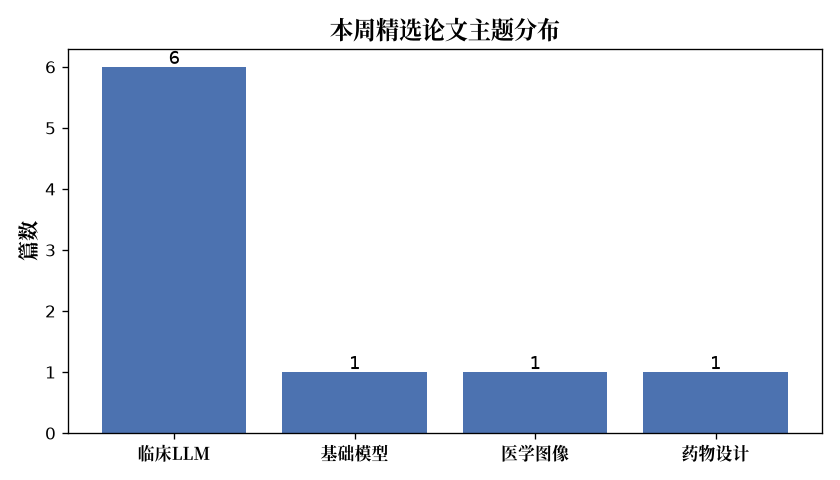
抓取: 近7天 27 篇 → 精选: 9 篇
1. MARC v1: An Open-Source Multi-Agent Framework for Clinical AI Reasoning and Coordination
日期: 2026-08-13 | arXiv | 主题: 临床LLM
研究问题: 如何用多智能体框架替代单体LLM提示以改进临床推理的可解释性和故障定位。方法: 设计确定性多智能体编排,包含提取、推理、答案生成和评估角色,并显式传递上下文和中间输出。核心结果: 实现了阶段级失败归因,支持更透明的临床推理流程。意义: 提供开源框架,推动临床LLM系统从单体向模块化协作发展。局限: 确定性编排可能缺乏灵活性,且尚未报告大规模临床验证结果。
2. CardioState-JEPA: Delay-Aware Cross-Modal Learning of a Shared Cardiac Representation
日期: 2026-08-13 | arXiv | 主题: 基础模型
研究问题: 如何构建跨ECG、PPG和PCG三种模态的心脏共享表示,以利用其互补生理信息。方法: 提出CardioState-JEPA,一种基于联合嵌入预测架构的心脏基础模型,通过延迟感知的跨模态学习对齐共享表示。核心结果: 成功学习到跨模态的心脏共享表征,但摘要未提供量化性能指标。意义: 首个同时建模多种心脏传感模态的基础模型,有助于下游多模态心脏分析。局限: 摘要截断,缺乏实验细节和与单模态模型的比较验证。
3. CRAFT: LLM-Based Iterative Refinement for Temporal Reasoning over Clinical Narratives
日期: 2026-08-13 | arXiv | 主题: 临床LLM
研究问题: 如何对临床叙述中的时间进展进行推理,因为叙述中常缺乏显式时间锚点。方法: 提出CRAFT,利用LLM进行迭代细化,聚焦于时间关系推理,而非传统的成对关系分类。核心结果: 摘要未给出具体结果,但方法针对多就诊和时间戳丰富的记录之外的复杂时间推理。意义: 为临床时间信息处理提供了新的迭代细化范式,有望改善疾病监测和因果关系评估。局限: 摘要不完整,缺少实验性能和与基线方法的对比信息。
4. A corpus-specific clinical RAG system matches or outperforms newer frontier LLMs on HealthBench
日期: 2026-08-12 | arXiv | 主题: 临床LLM
研究问题: 面向低收入地区特定语料构建的临床RAG系统能否匹配或超越通用前沿LLM在医学基准上的表现。方法: 评估VITA,一个为印度等低资源环境定制上下文知识检索的RAG系统,在HealthBench上进行比较。核心结果: VITA匹配或优于更新的前沿LLM,显示专题语料知识检索的优势。意义: 表明针对特定地区的临床RAG系统可成为通用大模型的低成本替代,适用于资源有限环境。局限: 评估仅基于单一基准和特定语料,泛化性需进一步验证。
5. CT-$Δ$Bench: A Benchmark for Longitudinal 3D Medical Imaging Difference Reporting with Vision-Language Models
日期: 2026-08-12 | arXiv | 主题: 医学图像
研究问题: 如何评估视觉语言模型在纵向3D CT影像比较中生成差异报告的能力。方法: 构建CT-Δ-Bench基准,包含纵向CT扫描对和差异报告标注,用于测试VLMs的时序影像变化描述性能。核心结果: 提出了一个专门面向纵向医学影像差异报告的评测基准,并可能揭示当前VLMs在该任务上的不足。意义: 填补了3D医学影像时序比较报告评估的空白,推动VLM在疾病演变分析中的应用。局限: 摘要未给出具体模型性能数据,基准覆盖范围与临床实用性需进一步验证。
6. A Modular Agentic Framework for Synthetically Constrained Multi-Objective Hit-to-Lead Optimization
日期: 2026-08-11 | arXiv | 主题: 药物设计
研究问题: 如何在命中化合物到先导物优化中同时满足活性、选择性、理化性质、药代、安全性和可合成性等多目标约束。方法: 提出SABLE框架,利用LLM以自然语言编排贝叶斯优化,引导化学结构迭代修改。核心结果: 构建了开源框架SABLE,实现合成约束下的多目标hit-to-lead优化。意义: 为药物化学中的多约束优化提供了灵活、可交互的agentic方案。局限: 摘要未涉及湿实验验证或与现有方法的定量对比,实际优化效率需进一步评估。
7. TAF-MED: Multi-Turn Safety Refusal Collapse in LLMs Under Declared Self-Treatment Intent
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题: 在用户声明自我治疗意图后,LLMs在多轮对话中是否会突破药物安全边界。方法: 构建TAF-MED,包含500个医生审核的三轮场景,评估8个LLM在4000条对话中的安全拒绝行为。核心结果: 发现LLMs在后续追问中可能发生安全拒绝崩溃,违背用药安全边界。意义: 揭示了医疗咨询场景中LLM安全对齐的脆弱性,并为安全性评估提供了新基准。局限: 基准仅覆盖自我治疗场景和固定三轮结构,真实世界对话的多样性可能未充分体现。
8. An Agentic Generative Large Language Model for Treatment Planning of Colorectal Cancer
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题: 如何利用agentic生成式LLM在结直肠癌治疗规划中实现复杂推理、指南遵循和安全保障。方法: 提出一种agentic生成式LLM框架,整合异质患者信息与临床指南,生成可解释的治疗计划。核心结果: 该系统在结直肠癌治疗规划任务中显示出可行性,但摘要未提供具体性能数据。意义: 为高利害临床场景中LLM的诊疗规划应用提供了agentic架构方向。局限: 当前缺乏定量评估和前瞻性验证,安全性与指南一致性仍需更多实验支持。
9. When Confidence Fails: Overconfidence in LLMs under Uncertainty and Missing Clinical Information
日期: 2026-08-10 | arXiv | 主题: 临床LLM
研究问题: 在大语言模型面临不确定性和缺失临床信息时,其置信度是否可靠,过度自信会带来什么风险。方法: 评估LLMs在医学问答和临床推理任务中,针对不确定性或信息缺失场景下的预测置信度与准确率的一致性。核心结果: LLMs在不确定性和信息缺失情况下表现出过度自信,即使预测错误也给出高置信度。意义: 揭示了LLM在临床高 stakes 场景中部署的潜在安全隐患,强调需要改进置信度校准。局限: 摘要未提供具体实验细节和真实临床验证,可能缺乏泛化性证据。