arXiv 医学AI 周报(2026-08-30)(8/24–8/30)
[预印本]期间: 2026-08-23 ~ 2026-08-30
生成时间: 2026/08/30 19:07
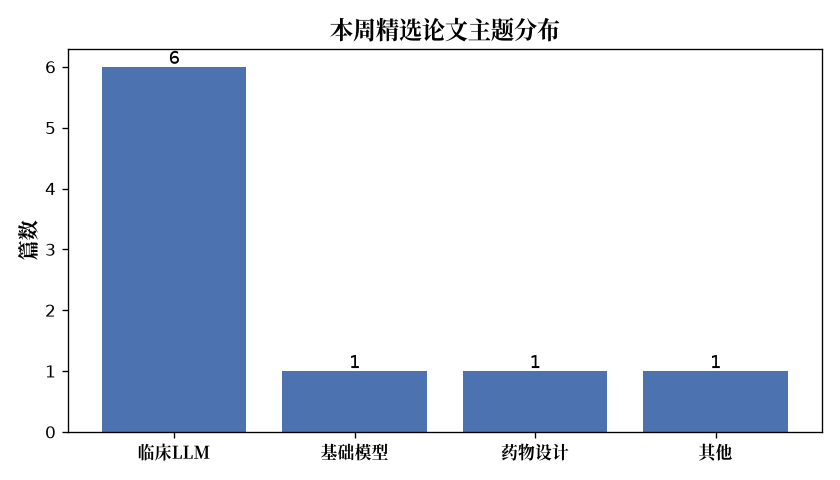
抓取: 近7天 24 篇 → 精选: 9 篇
1. Making Clinical Language Models Auditable: Concept-Guided Fine-Tuning for Robust Prediction
日期: 2026-08-27 | arXiv | 主题: 临床LLM
研究问题: 临床语言模型在部署偏移下因利用笔记特定伪影(如模板、分隔符)而失败,缺乏可审计性。方法: 提出CAST框架,使用稀疏自编码器(SAE)暴露稀疏概念并引导微调,抑制与患者状态无关的伪影。核心结果: 通过概念引导的伪影抑制,提升了模型在分布偏移下的鲁棒性和可审计性。意义: 使临床语言模型更透明、可靠,有助于实际部署中的信任与调试。局限: 依赖SAE概念提取质量,且摘要未提供具体性能数值或与基线对比的详细结果。
2. Benchmarking Clinical Decision Pathway Adherence in Large Language Models
日期: 2026-08-27 | arXiv | 主题: 临床LLM
研究问题: 现有医学LLM基准主要评估最终答案准确性,缺乏对临床决策路径(CDP)依从性的系统评估。方法: 引入MEGA-CDP基准,专门评估模型遵循临床实践指南定义的多步决策路径的能力。核心结果: 构建了面向CDP依从性的基准,可衡量模型在诊断推理过程中对指南步骤的遵循程度。意义: 弥补了现有基准对指南依从性评估的空白,推动更安全可靠的医学LLM发展。局限: 基准可能仅覆盖特定疾病或指南,且摘要未给出模型评估结果或基准规模细节。
3. Surgical Alignment in Knowledge Graph Training for Clinical Diagnosis with Large Language Models
日期: 2026-08-27 | arXiv | 主题: 临床LLM
研究问题: 如何将生物医学知识图谱(KG)信号有效整合到LLM中以提升临床诊断能力,以及不同整合方式的影响。方法: 系统比较五种KG任务公式、三种训练范式、两个KG和三个基础LLM,进行大规模实验研究。核心结果: 所有训练范式相对基线均有提升,但不同任务公式和KG选择对效果有显著影响。意义: 为知识图谱增强的临床LLM训练提供了系统性的经验指导,有助于选择最优整合策略。局限: 实验局限于特定KG和LLM集合,结论可能无法推广到其他医学领域或更大规模模型。
4. A Multimodal Foundation Model for Longitudinal Patient Representation and Scalable Insight Generation in Oncology
日期: 2026-08-25 | arXiv | 主题: 基础模型
研究问题: 精准肿瘤学需要能够整合多模态数据并建模患者随时间演变状态的纵向基础模型。方法: 开发oFM,基于167万癌症患者的真实世界队列,整合临床轨迹、DNA、RNA和H&E病理图像,并采用患者级分区进行训练。核心结果: 构建了大规模多模态肿瘤学基础模型,支持纵向患者表征和可扩展的洞察生成。意义: 为肿瘤学提供统一的多模态患者建模框架,有望改善癌症演变理解和个体化治疗。局限: 依赖真实世界数据质量,可能存在选择偏差;多模态整合和纵向建模的计算复杂度高,且摘要未给出具体下游任务性能。
5. Gated Activation Steering for Reducing Sycophancy & Hallucination in Medical Question Answering
日期: 2026-08-24 | arXiv | 主题: 临床LLM
研究问题: 如何减少医学问答中LLM的谄媚和幻觉行为。方法: 提出门控激活引导(Gated Activation Steering)技术,通过调整模型内部激活来抑制不良输出。核心结果: 该方法能有效降低医学问答中的谄媚和幻觉发生率。意义: 提升临床场景下LLM回答的可靠性和事实一致性。局限: 摘要未完整,可能依赖特定模型架构或数据集,泛化性需进一步验证。
6. Future Querying: Can LLMs Serve as Implicit Medical World Models?
日期: 2026-08-24 | arXiv | 主题: 临床LLM
研究问题: 探究LLM能否作为隐式医学世界模型,回答关于患者未来的时间索引临床查询。方法: 提出“未来查询”(future querying)范式,直接向LLM提出时间相关的临床问题并评估其预测能力。核心结果: LLM在部分未来临床查询上表现出一定预测能力,但整体性能有限。意义: 为利用非结构化文本进行临床预测提供新思路,减少对结构化数据的依赖。局限: 可能缺乏真实世界验证,且预测准确性和可靠性尚需大规模临床评估。
7. MolEmb: Multimodal Large Language Models Can Be Strong Molecular Embedding Models
日期: 2026-08-24 | arXiv | 主题: 药物设计
研究问题: 多模态大语言模型能否作为强效的分子嵌入模型,提供可复用的分子表示。方法: 利用多模态LLM整合分子结构信息与语言描述,生成条件化的分子嵌入向量。核心结果: MolEmb在分子性质预测和虚拟筛选等任务上优于专门构建的单视图分子编码器。意义: 为药物发现提供具有语言接口的通用分子嵌入基础设施,支持灵活调整表示。局限: 多模态LLM计算成本高,且嵌入质量可能受训练数据覆盖范围限制。
8. Proxy reliance in large language model decisions is uncalibrated to predictive evidence
日期: 2026-08-24 | arXiv | 主题: 其他
研究问题: LLM决策中对代理变量(如人口统计学属性)的依赖是否与预测证据校准。方法: 在分诊和贷款等任务中测量因果代理效应,区分歧视性使用与合理推断。核心结果: 发现LLM的代理依赖与预测证据之间未校准,决策变化可能源于非预测性因素。意义: 为审计LLM决策中的公平性提供因果视角,避免将合理推断误判为歧视。局限: 研究可能局限于特定任务和模型,因果效应估计的假设需进一步检验。
9. SDoH-Aware Narrative Anchoring Bias in Medical LLMs for Trustworthy Clinical Decision Support
日期: 2026-08-24 | arXiv | 主题: 临床LLM
研究问题: 医学LLM在面对相同临床病例但不同患者社会人口学特征(SDoH)叙述时,是否会产生锚定偏倚导致回答改变。方法: 使用NarrativeShield SDoH MedQA反事实数据集,通过控制变量法对比同一病例在不同患者叙述下模型回答的一致性。核心结果: 模型存在SDoH感知的叙述锚定偏倚,即同一病例的临床答案会因患者人口学背景描述的改变而发生变化。意义: 揭示了医学LLM在临床决策支持中的公平性风险,为构建可信赖的医疗AI系统提供了重要评估框架。局限: 仅评估了特定数据集上的偏倚表现,未涉及临床实际部署环境的验证及偏倚缓解方案。