arXiv 医学AI 周报(2026-09-06)(8/31–9/6)
[预印本]
📂 完整详情(多页 HTML)
在新窗口打开 ↗
期间: 2026-08-30 ~ 2026-09-06
生成时间: 2026/09/06 02:34
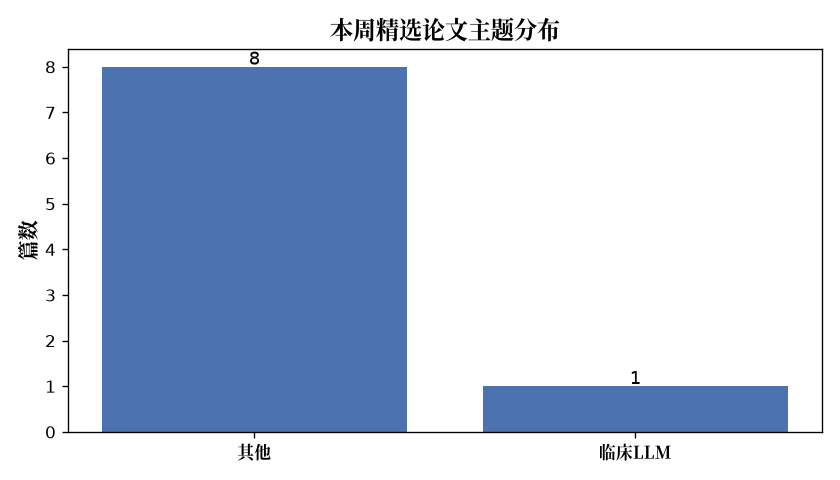
抓取: 近7天 27 篇 → 精选: 9 篇
1. Accountable AI with Grounded, Faithful, Consistent, Actionable Rationales: A Case Study in Clinical Trial Matching with VERDICT
日期: 2026-09-03 | arXiv | 主题: 其他
(无分析)
2. Untangling the Mechanisms of Misleading Context in Medical Question Answering
日期: 2026-09-02 | arXiv | 主题: 其他
(无分析)
3. Disease Burden over Skin Tone: Decomposing the Dermatology-AI Generalization Gap
日期: 2026-09-02 | arXiv | 主题: 其他
(无分析)
4. ClinTraceBench: Source-Verifiable Longitudinal Clinical Reasoning over EHR-Derived Dialogues
日期: 2026-09-01 | arXiv | 主题: 其他
(无分析)
5. One note in three: a verified census of three deployed AI scribes, and the instrument that counted it
日期: 2026-08-31 | arXiv | 主题: 其他
(无分析)
6. LLM Judges Verify Presence, Not Absence: Omission Blindness in AI Clinical Notes and What Recovers It
日期: 2026-08-31 | arXiv | 主题: 其他
(无分析)
7. Deploying DeepSeek 175B Locally on a Single Consumer-Grade RTX 4060 Laptop with 32GB RAM for 200k-Scale Protein-Ligand Virtual Screening
日期: 2026-08-31 | arXiv | 主题: 其他
(无分析)
8. Uncertainty of Vision Medical Foundation Models
日期: 2026-08-31 | arXiv | 主题: 其他
(无分析)
9. GPAgentBench-2K: Benchmarking Large Language Model Agents in Complex Clinical Action Space
日期: 2026-08-31 | arXiv | 主题: 临床LLM
研究问题: 现有临床LLM评测基准将临床工作流简化为静态预测或动作空间粗糙的无约束MDP,无法刻画真实基层诊疗决策的复杂性。 方法: 基于专家验证的病历记录,构建首个面向基层医疗决策的约束马尔可夫决策过程(CMDP)LLM智能体基准GPAgentBench-2K,在复杂临床动作空间中评测智能体行为。 核心结果: 摘要未给出具体数字,但该基准对主流LLM智能体在约束临床动作空间下的决策能力进行了系统评测(原文在此处被截断)。 意义: 首次将CMDP形式化引入临床LLM智能体评测,更贴近真实诊疗约束,为临床智能体的安全性与可靠性评估提供了标准化工具。 局限: 局限于基层医疗场景,动作空间与疾病覆盖可能不代表专科及住院诊疗;摘要截断,模型覆盖范围与评测结论的稳健性有待查证原文。